
IO密集型任务线程池调优(上)
在线支付业务中,经常会遇到掉单问题:用户已完成支付,但订单状态仍显示"待付款"。通常,用户支付完成后,第三方支付平台会通过梯度通知机制向商户同步支付结果。然而,若支付平台因网络波动、系统故障等原因导致通知失败,就需要引入补偿机制——比如:通过定时任务每隔一段时间主动查询特定时段内的待支付订单,批量发送至第三方支付平台查询支付结果,并同步更新系统订单状态,通知下游服务。为了高效处理这类订单,通常会借助线程池实现并发处理。
分析业务特征
Q:定时任务多久查一次?
A:假设用户通常在5分钟内完成支付,那么定时任务每隔5分钟查询一次。

Q:每次查询的时间跨度是多少?
A:查一天前到5分钟前待支付的订单。

Q:每次查询出的待支付订单期望多久时间处理完?
A:每批订单期望1分钟内处理完。

Q:平时和大促期间,单位时间内大约发生多少次掉单情况?
A:平时每5分钟大约掉单1200次,大促期间每5分钟大约5000次。
评估 TPS
平时:
每次查询出 1200 笔待支付订单,要求 1 分钟内处理完。
大促:
每次查询出 5000 笔待支付订单,要求 1 分钟内处理完。
平时 20 TPS 和大促 83 TPS 对下游服务(数据库、RPC)有没有压力,如果大促期间 TPS 对下游服务有压力,就需要业务侧妥协,看看能否协商到 40 TPS,也就是 5000 笔待支付订单保障 秒,大约 2 分钟左右处理完。
案例准备
为了更好的模拟掉单业务的处理,这里准备了一个案例,方便进行测试验证。
定时任务:
@Scheduled(fixedDelayString = "5000")
public void scanAndSync() {
    long r = round.incrementAndGet();
    long submittedHere = 0;
    long droppedHere = 0;

    for (int i = 0; i < batchSize; i++) {
        String orderId = "order-" + r + "-" + i;
        long rtMs = ThreadLocalRandom.current().nextLong(RT_MIN_MS, RT_MAX_MS);
        try {
            demo.syncAsync(new PaymentSyncDemo.OrderSyncRequest(orderId, "io", rtMs));
            submittedHere++;
        } catch (RejectedExecutionException e) {
            droppedHere++;
        }
    }

    log.info("掉单扫描 round={}:生成 {},提交 {},池满丢弃 {}",
            r, batchSize, submittedHere, droppedHere);
}丢入线程池,异步处理掉单:
public void syncAsync(OrderSyncRequest request) {
    asyncExecutor.execute(() -> {
        try {
            occupyThread(request);
        } catch (InterruptedException e) {
            Thread.currentThread().interrupt();
        }
    });
}

public void occupyThread(OrderSyncRequest request) throws InterruptedException {
    if (IO.equals(request.type())) {
        Thread.sleep(request.rtMs());
    } else {
        long deadline = System.nanoTime() + request.rtMs() * 1_000_000;
        long sink = 0;
        while (System.nanoTime() < deadline) {
            sink += ThreadLocalRandom.current().nextInt(100);
        }
        cpuSink = sink;
    }
}
基线压测观察任务平均处理时长
通过 JMeter 基线压测,观察到:

业务的平均处理时长约为 204 ms。
任务类型
掉单处理涉及第三方接口的调用,属于典型的 IO 密集型任务。
如果直接套公式
IO 密集型任务,8 核 CPU:
queueCapacity = 100
实测时,你会发现:
队列瞬间被填满,工作线程数瞬间提升到最大线程数,1200 个任务瞬间有 999 个被拒绝。这显然不是我们想要的结果。
另外,任务处理能力达到了 147 TPS,比预期 20 TPS 提升了约 7.4 倍,如果下游服务最大承受能力是 40 TPS,这就远超下游服务能力。
实测指标
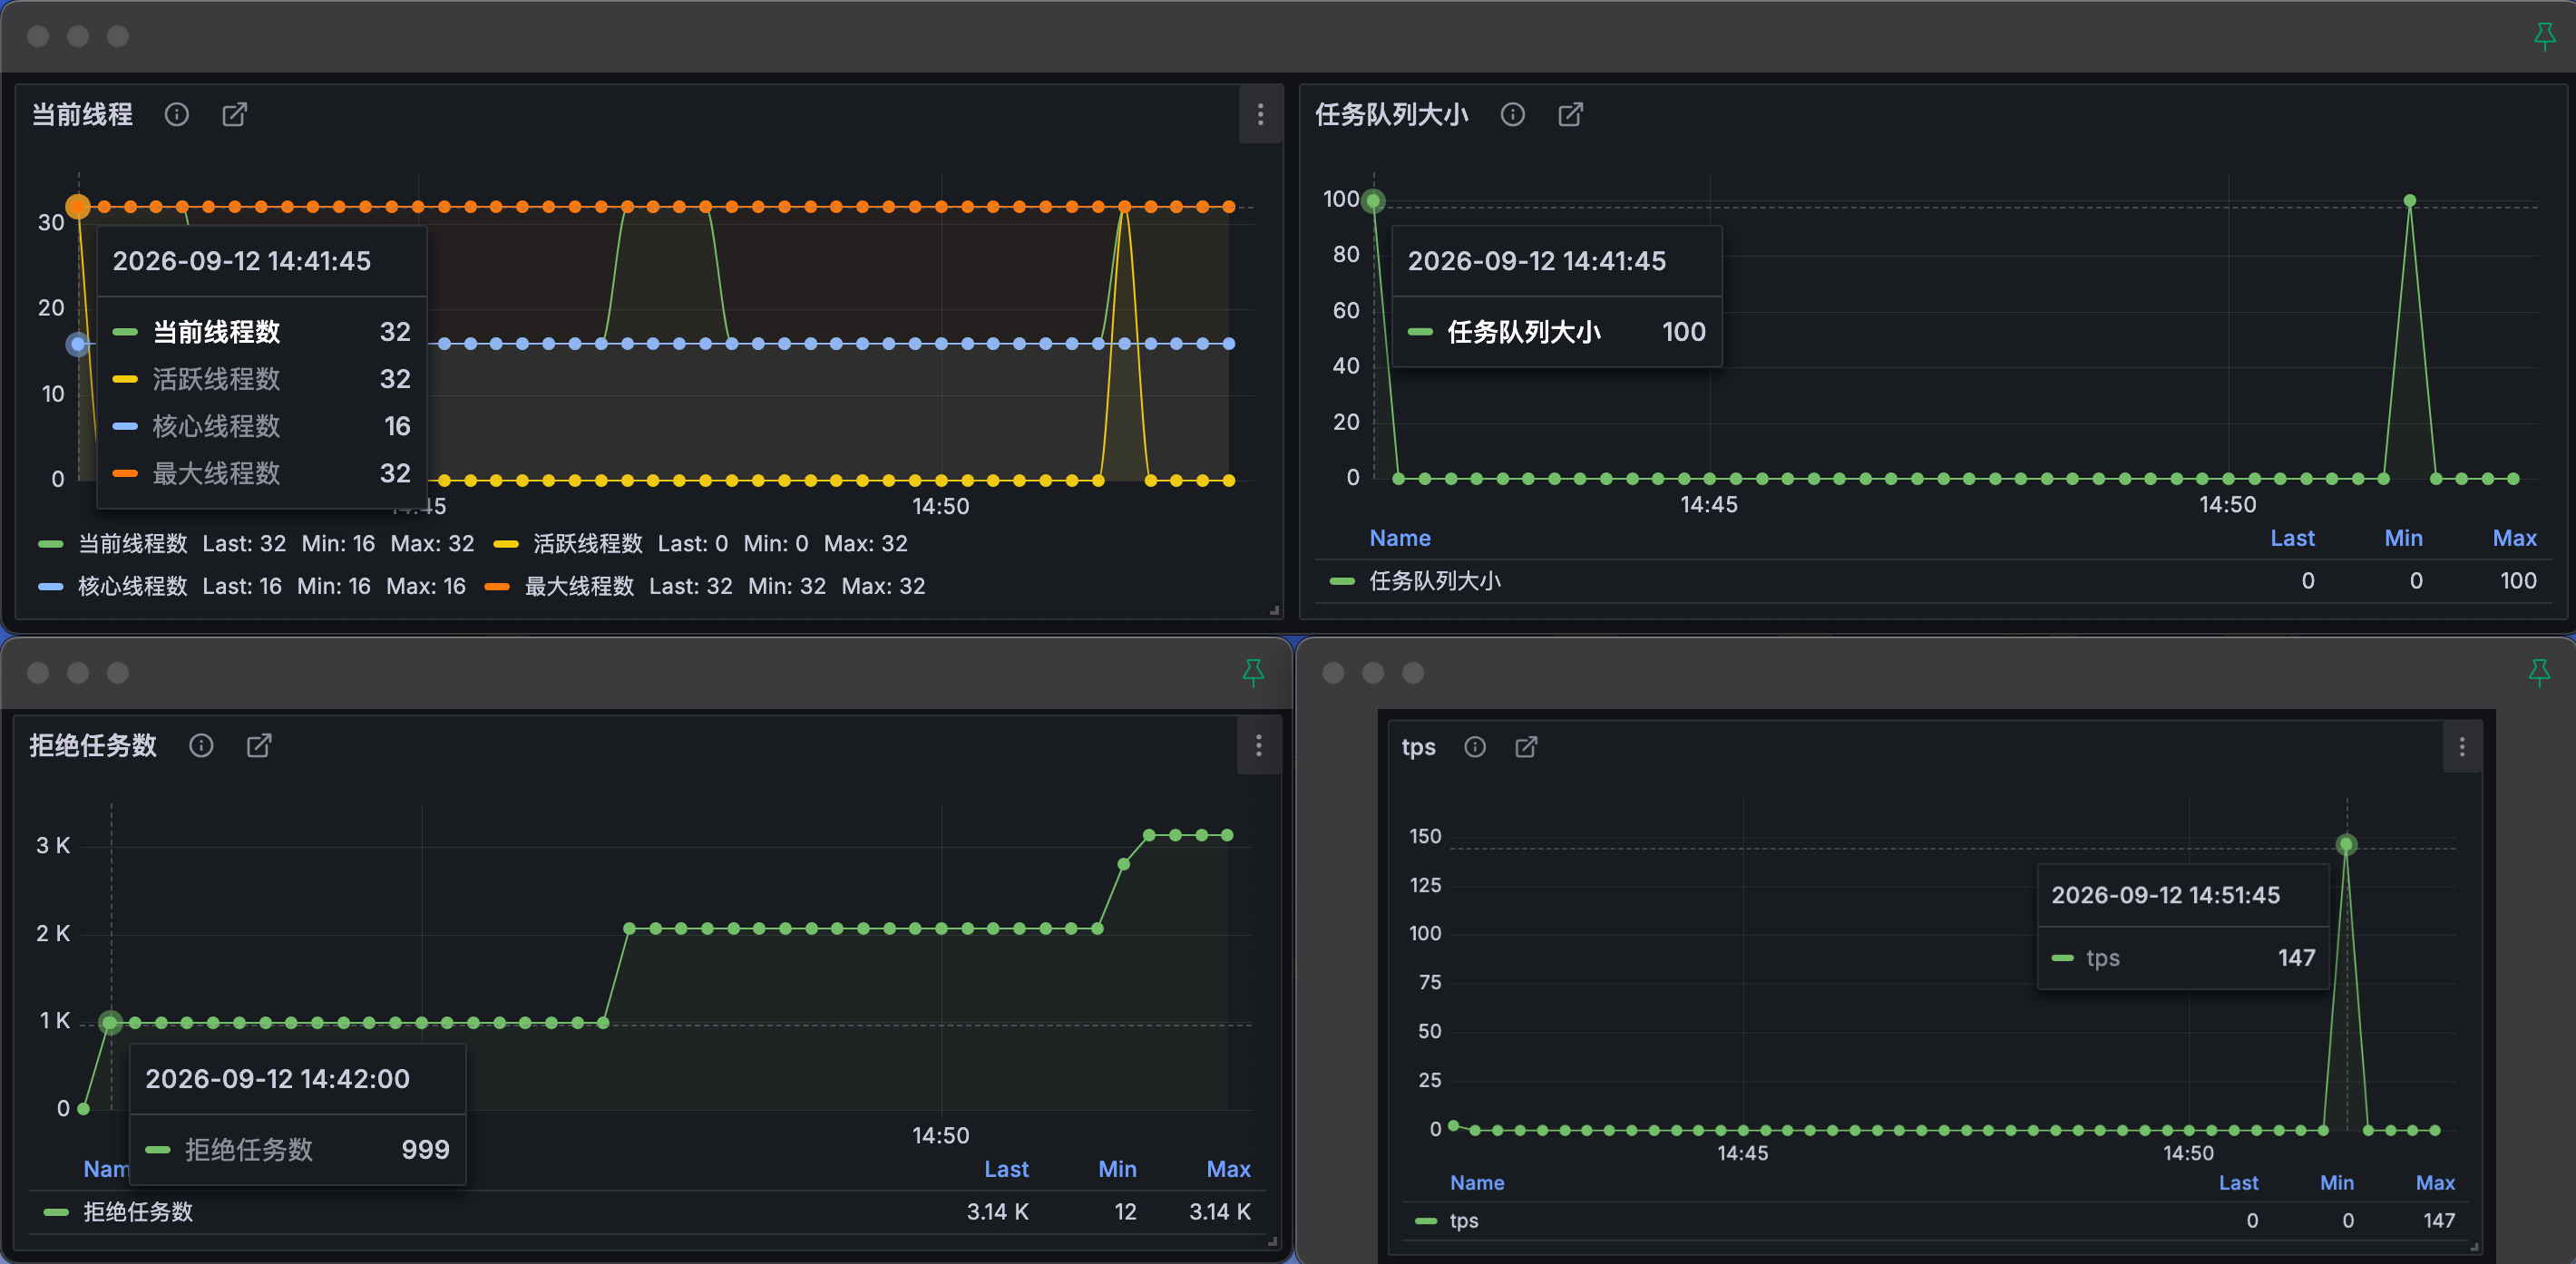
应用日志
2026-09-12T14:41:43.418+08:00  INFO 35520 --- [thread-pool-lab] [   scheduling-1] c.g.p.c.tpool.app.OrderRecoveryJob       : 掉单扫描 round=1:生成 1200,提交 201,池满丢弃 999

2026-09-12T14:46:43.485+08:00  INFO 35520 --- [thread-pool-lab] [   scheduling-1] c.g.p.c.tpool.app.OrderRecoveryJob       : 掉单扫描 round=2:生成 1200,提交 132,池满丢弃 1068

2026-09-12T14:51:43.531+08:00  INFO 35520 --- [thread-pool-lab] [   scheduling-1] c.g.p.c.tpool.app.OrderRecoveryJob       : 掉单扫描 round=3:生成 1200,提交 132,池满丢弃 1068
排队论估算
工作线程数 c 的计算方法
根据排队论:
可以推导:
进一步可得:
线程数和利用率估算
当 ρ = 1 时,c = λS
平时 20 TPS:
至少需要 5 个线程。
代入排队论计算器,算得:
线程数 c    平均等待时间 Wq     利用率 ρ
  5         129.799 ms        0.816
  6         32.3721 ms        0.68
  7         10.2442 ms        0.582857
  8         3.38694 ms        0.51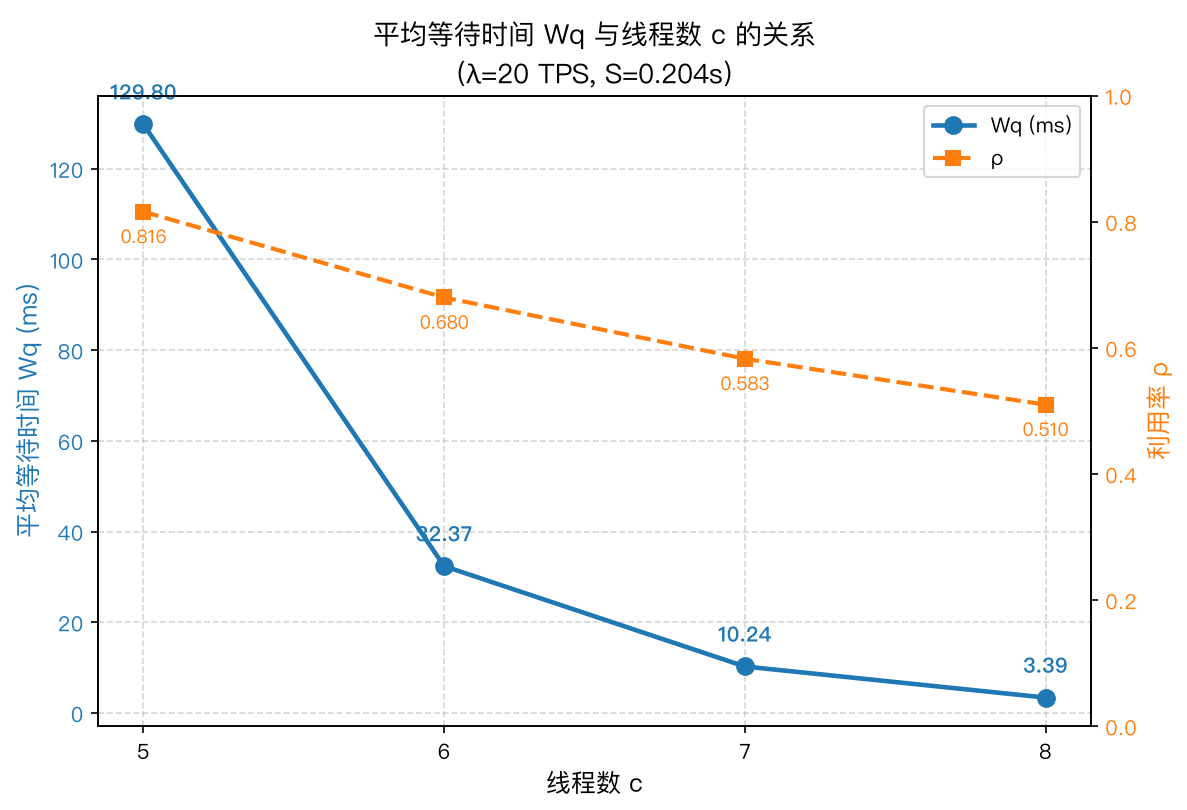
当 c = 5 时,ρ = 0.816 接近 1,线程池接近饱和状态,平均等待时间高达 129.8 ms —— 已经接近业务处理时长 204 ms 的 63%,意味着任务有一大半时间在排队。
c 从 5 增加到 6,等待时间急剧下降到 32.4 ms(下降 75%),仅仅加了一个线程,收益明显提升。
c 从 7 增加到 8,等待时间继续下降,但边际效益递减:10.2 ms → 3.4 ms,此时利用率已经降到 0.51,线程池有近一半空闲。
实践中 c = 6 或 c = 7 是一个良好的平衡点:既保证了排队等待时间较低,又不会让线程池利用率过低造成资源浪费。
当我们取 c = 7 时,线程池的最大处理能力
至此我们完成了目标 TPS = 20 时,线程数、利用率、线程池最大处理能力的估算
c = 7
ρ = 0.58
线程池最大处理能力 ≈ 34 TPS
队列容量估算
当前业务的流量属于周期性批量突发流量:
- 1200 个任务在几毫秒内同时到达;
- 两次触发之间(5 分钟)基本没有新任务。
所以不能直接用 Little's Law 估算 queueCapacity。
瞬时流量首先应考虑尽量用队列接住,然后线程池按能力消化:
假设我们预留 30% 的 buffer,。
采用固定大小线程池,即:corePoolSize = maximumPoolSize。
至此,我们有了线程池的理论参数配置:
corePoolSize: 7
maximumPoolSize: 7
queueCapacity: 1560
实测验证
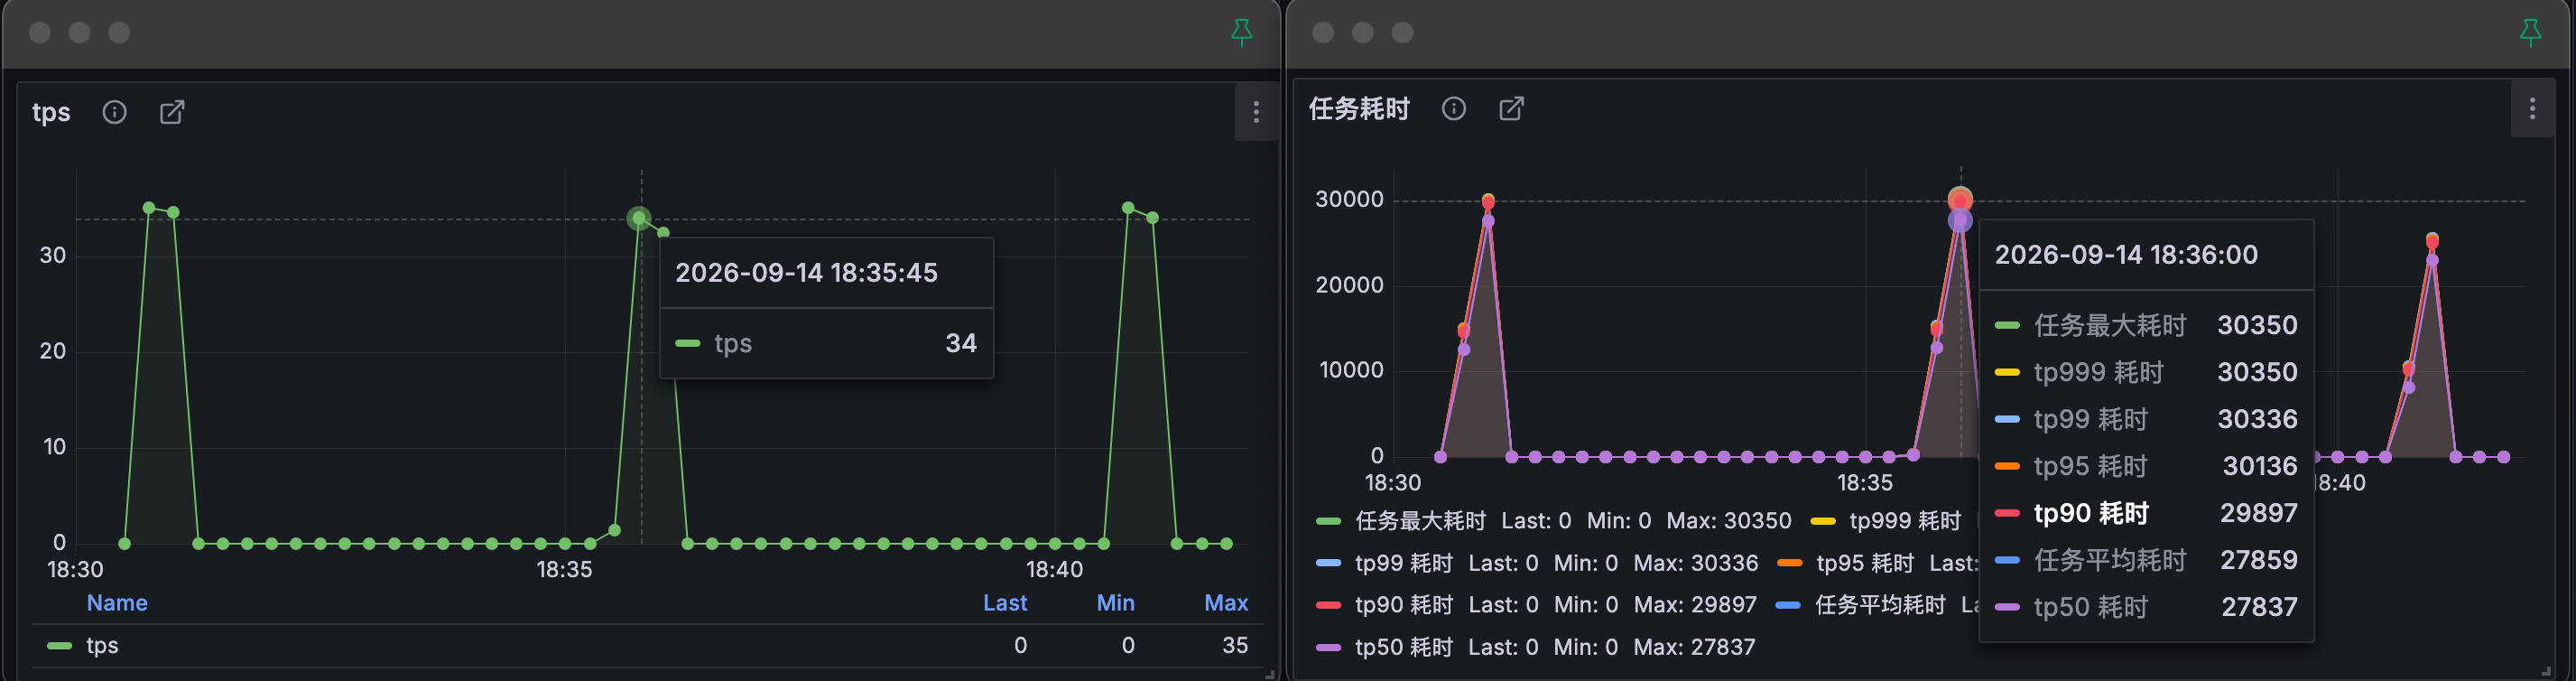
- 单个任务最大耗时 30.35 秒,远小于 1 分钟的业务期望,超额满足业务对于延迟的要求。
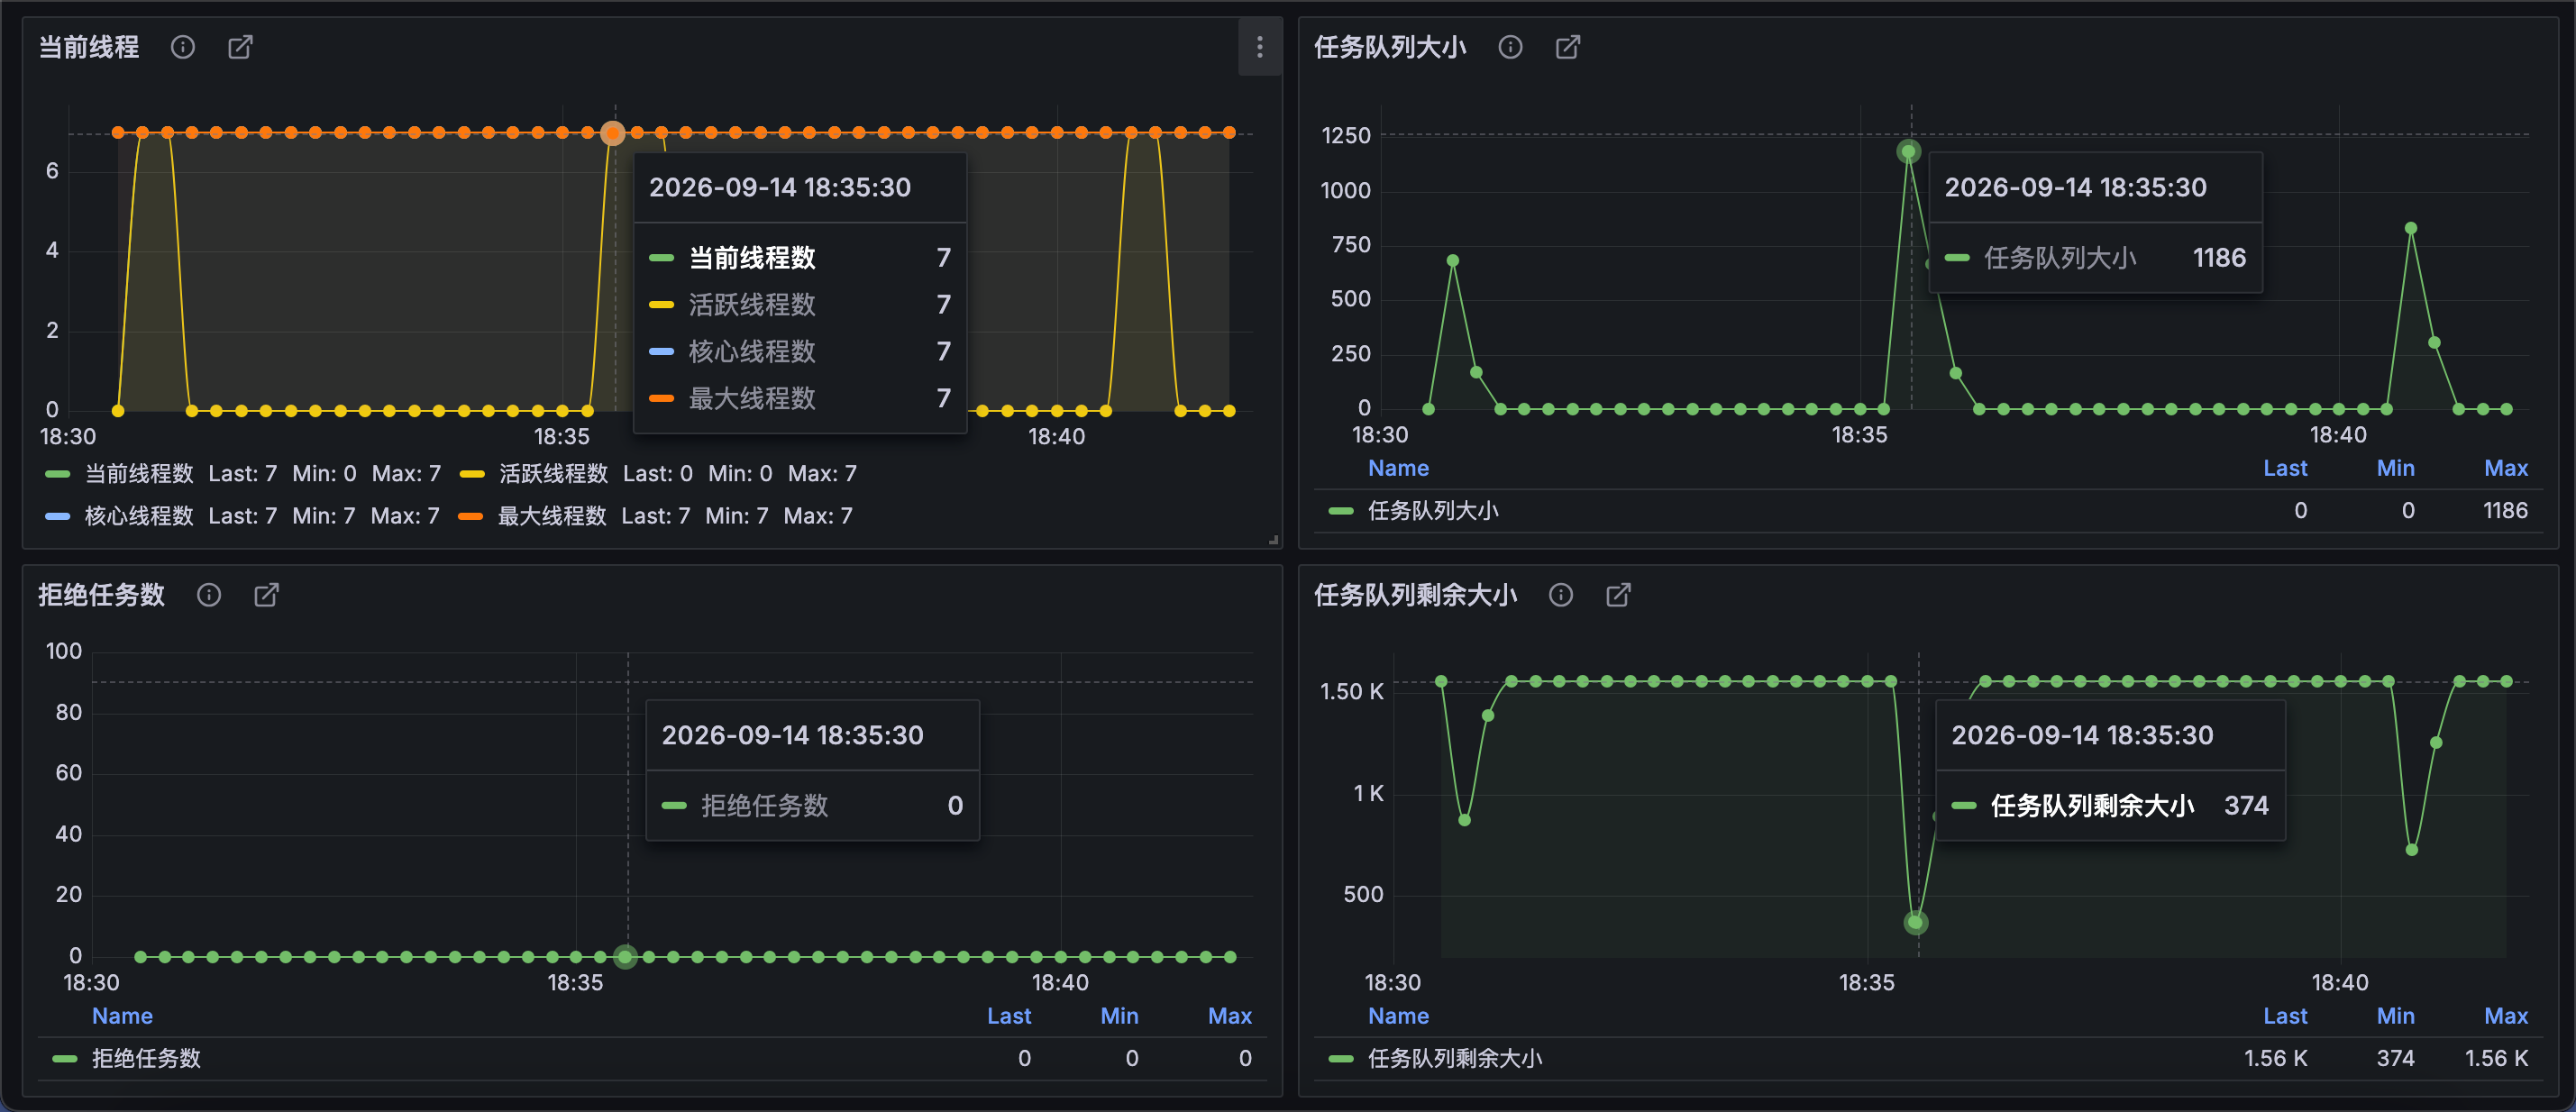
- 吞吐量达到了预估的线程池最大处理能力 34 TPS,满足业务对于吞吐量的要求。队列任务消化期间,线程池 100% 活跃。
- 队列稳稳接住瞬时流量,没有触发任务拒绝。
TPS / RT
队列大小 / 拒绝任务数
应用日志
2026-09-14T18:30:28.960+08:00  INFO 81731 --- [thread-pool-lab] [   scheduling-1] c.g.p.c.tpool.app.OrderRecoveryJob       : 掉单扫描 round=1:生成 1200,提交 1200,池满丢弃 0
2026-09-14T18:35:28.969+08:00  INFO 81731 --- [thread-pool-lab] [   scheduling-1] c.g.p.c.tpool.app.OrderRecoveryJob       : 掉单扫描 round=2:生成 1200,提交 1200,池满丢弃 0
2026-09-14T18:40:28.965+08:00  INFO 81731 --- [thread-pool-lab] [   scheduling-1] c.g.p.c.tpool.app.OrderRecoveryJob       : 掉单扫描 round=3:生成 1200,提交 1200,池满丢弃 0
继续加压
当前配置下,线程池最大处理能力为 34 TPS,理论上 1 分钟能处理 个任务。
为了找到线程池真正的性能瓶颈,我们调大 queueCapacity 至 :
queueCapacity: 2652阶梯调整流量:
第一轮、batchSize = 2040
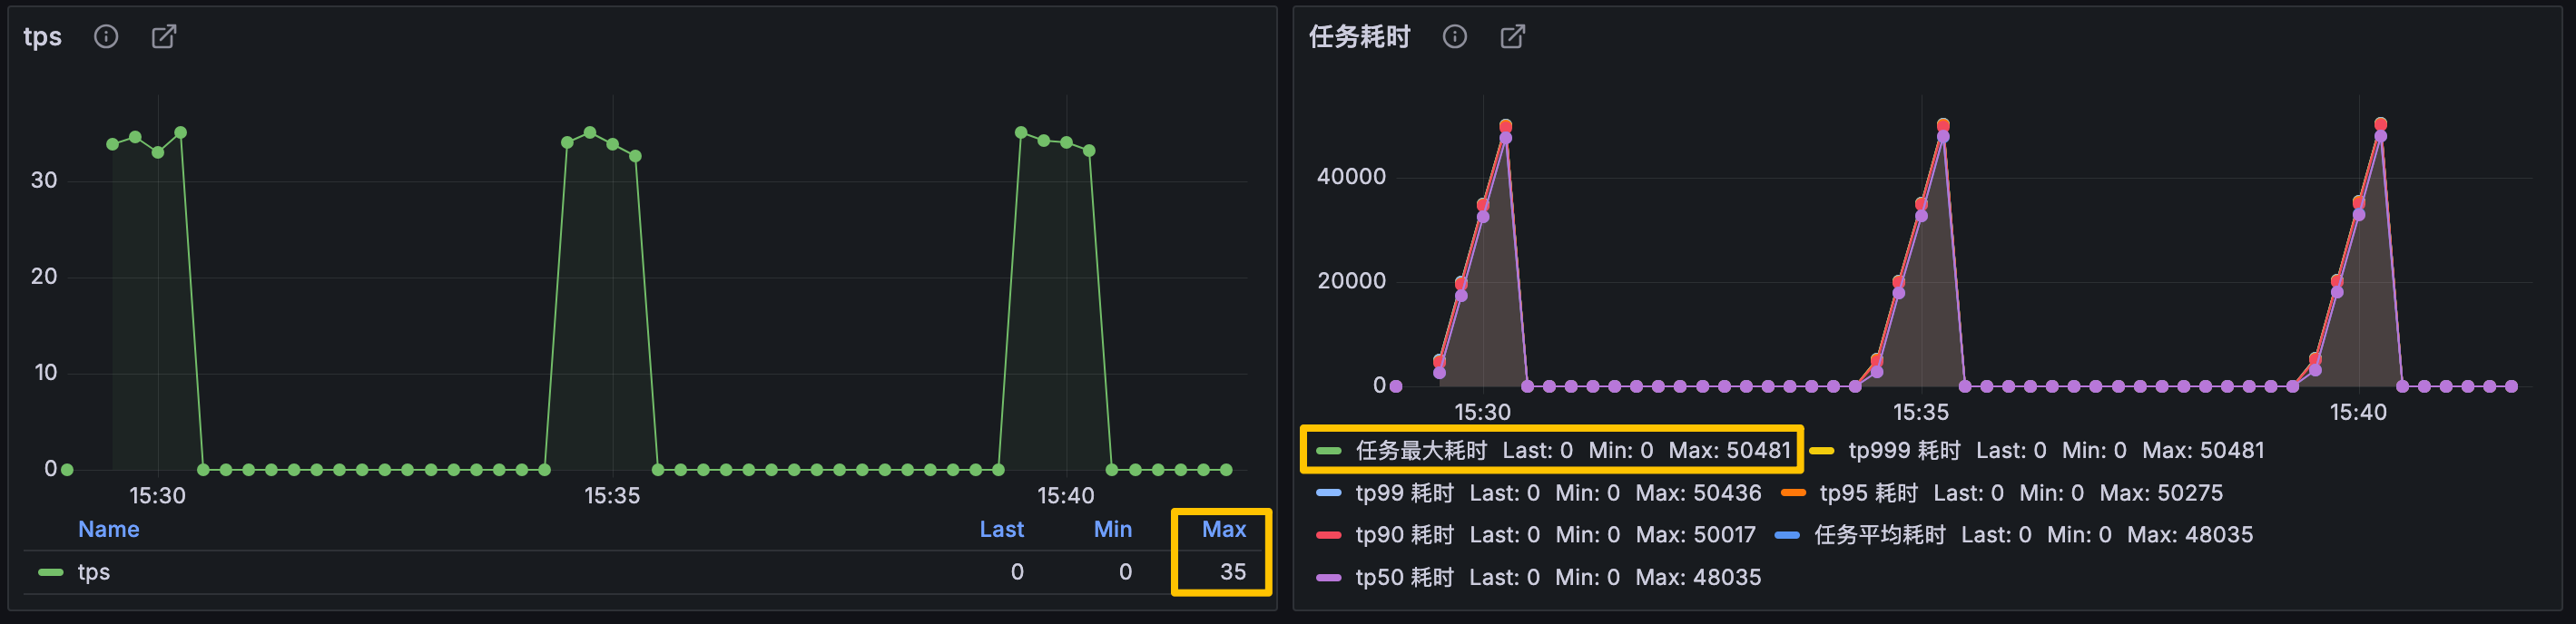
2026-09-15T15:29:20.739+08:00  INFO 47329 --- [thread-pool-lab] [   scheduling-1] c.g.p.c.tpool.app.OrderRecoveryJob       : 掉单扫描 round=1:生成 2040,提交 2040,池满丢弃 0
2026-09-15T15:34:20.732+08:00  INFO 47329 --- [thread-pool-lab] [   scheduling-1] c.g.p.c.tpool.app.OrderRecoveryJob       : 掉单扫描 round=2:生成 2040,提交 2040,池满丢弃 0
2026-09-15T15:39:20.721+08:00  INFO 47329 --- [thread-pool-lab] [   scheduling-1] c.g.p.c.tpool.app.OrderRecoveryJob       : 掉单扫描 round=3:生成 2040,提交 2040,池满丢弃 0
第二轮、batchSize = 2200
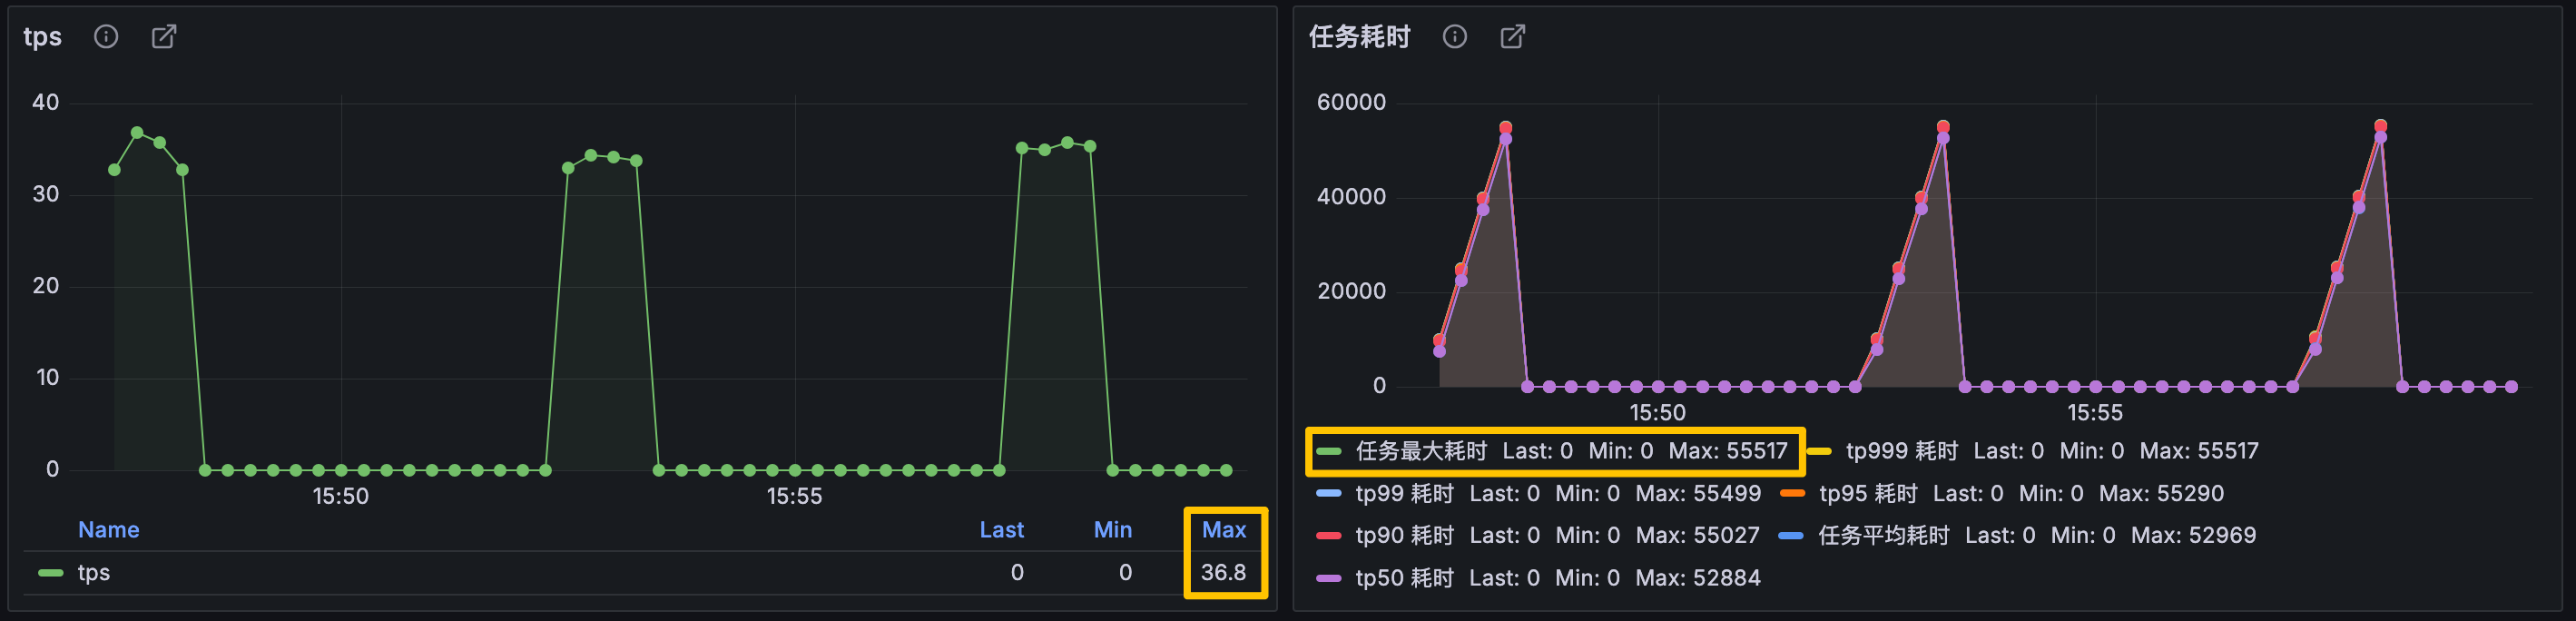
2026-09-15T15:47:18.207+08:00  INFO 49898 --- [thread-pool-lab] [   scheduling-1] c.g.p.c.tpool.app.OrderRecoveryJob       : 掉单扫描 round=1:生成 2200,提交 2200,池满丢弃 0
2026-09-15T15:52:18.198+08:00  INFO 49898 --- [thread-pool-lab] [   scheduling-1] c.g.p.c.tpool.app.OrderRecoveryJob       : 掉单扫描 round=2:生成 2200,提交 2200,池满丢弃 0
2026-09-15T15:57:18.187+08:00  INFO 49898 --- [thread-pool-lab] [   scheduling-1] c.g.p.c.tpool.app.OrderRecoveryJob       : 掉单扫描 round=3:生成 2200,提交 2200,池满丢弃 0
第三轮、batchSize = 2400
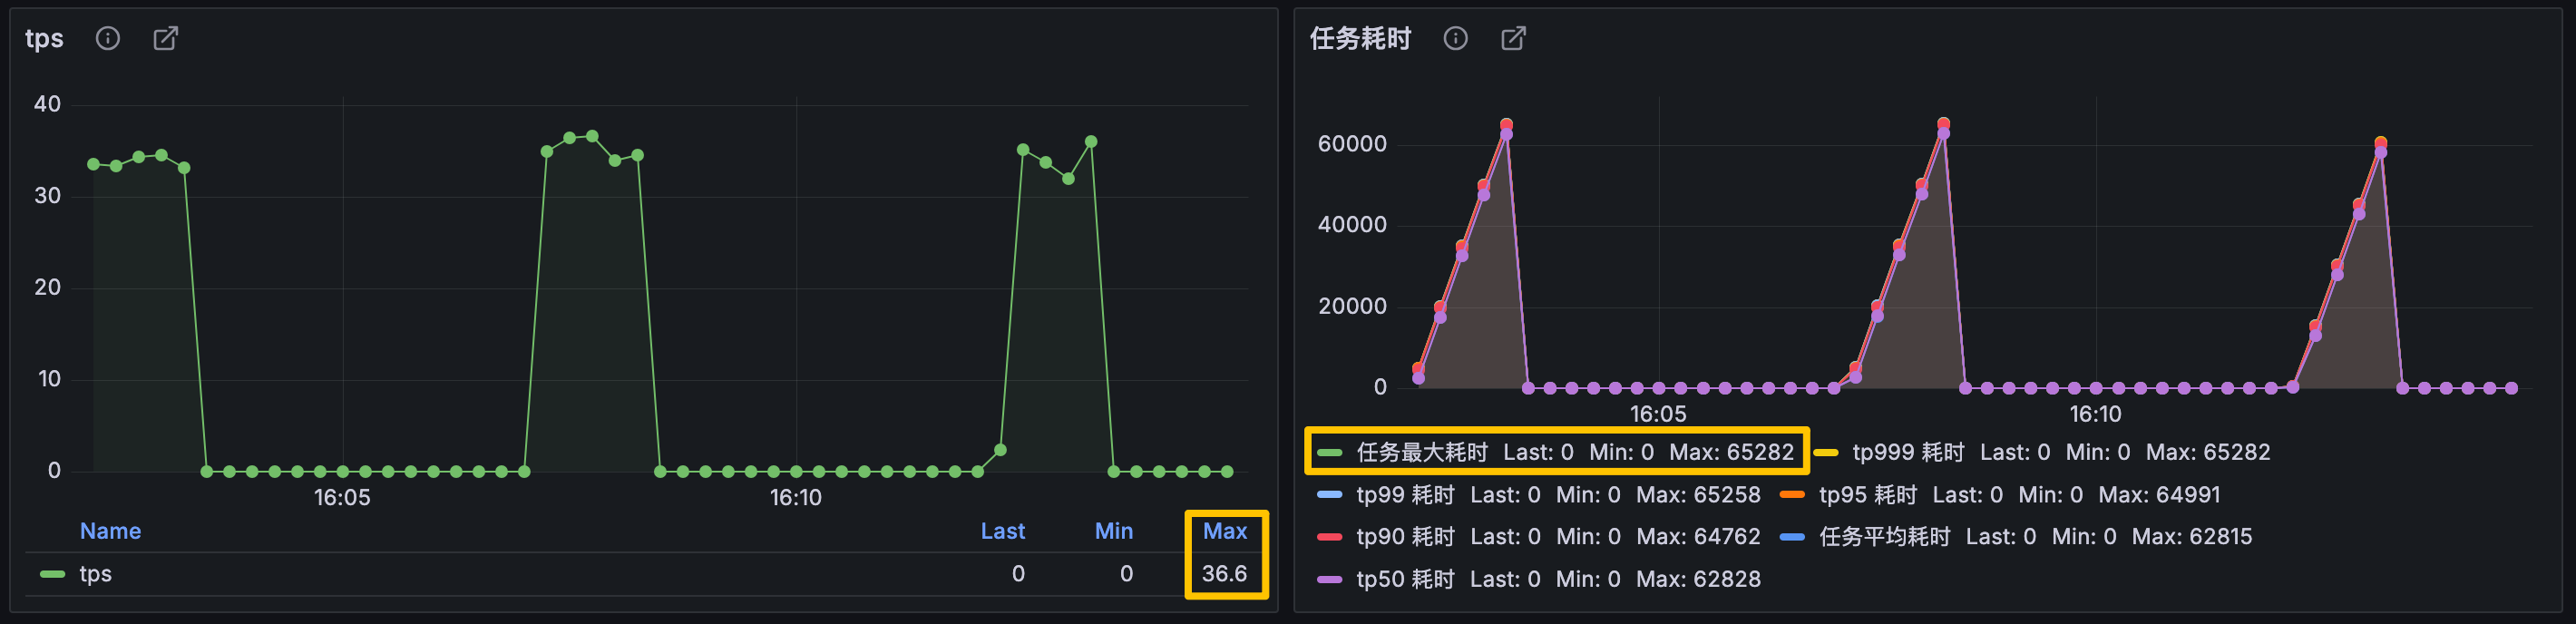
2026-09-15T16:02:08.497+08:00  INFO 52069 --- [thread-pool-lab] [   scheduling-1] c.g.p.c.tpool.app.OrderRecoveryJob       : 掉单扫描 round=1:生成 2400,提交 2400,池满丢弃 0
2026-09-15T16:07:08.493+08:00  INFO 52069 --- [thread-pool-lab] [   scheduling-1] c.g.p.c.tpool.app.OrderRecoveryJob       : 掉单扫描 round=2:生成 2400,提交 2400,池满丢弃 0
2026-09-15T16:12:10.707+08:00  INFO 52069 --- [thread-pool-lab] [   scheduling-1] c.g.p.c.tpool.app.OrderRecoveryJob       : 掉单扫描 round=3:生成 2400,提交 2400,池满丢弃 0